
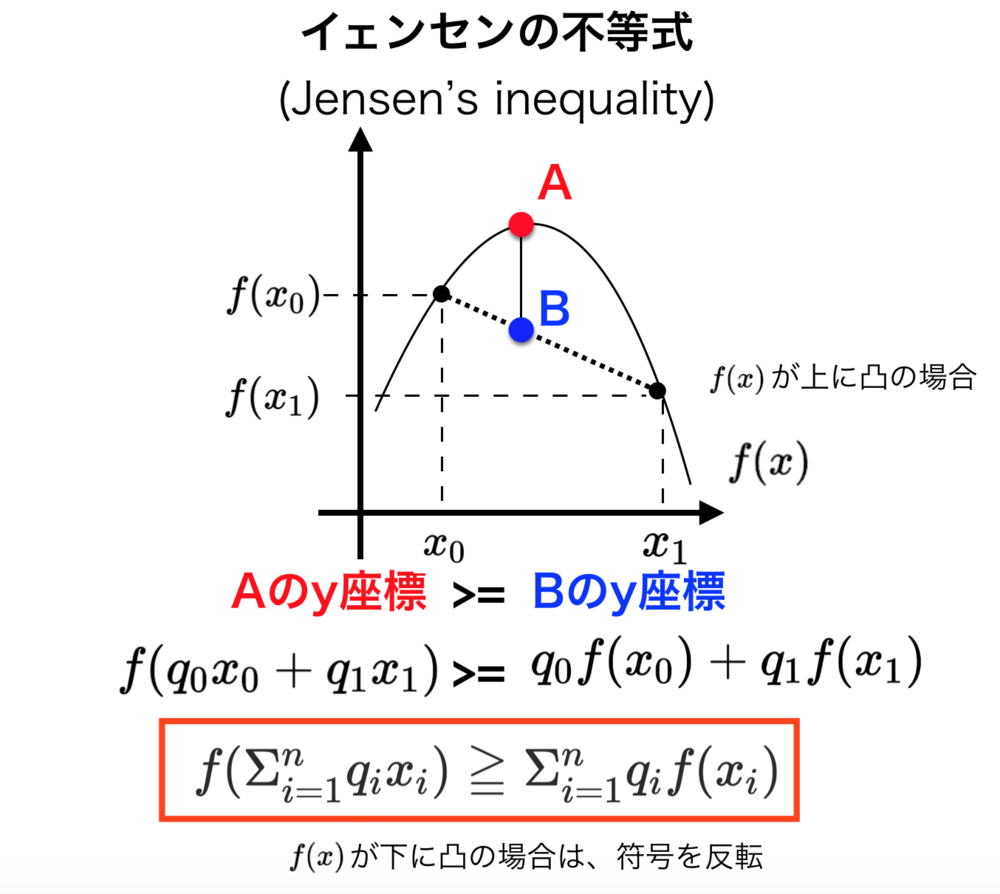
なぜ機械学習やデータサイエンスの現場において、イェンセンの不等式はこれほど重宝されているのでしょうか。その理由は、「直接計算できない複雑な確率モデルに対し、最適化可能な下界(バウンド)を構成できるから」です。
代表的な応用例の筆頭が、2つの確率分布 $P$ と $Q$ の差異を測る「カルバック・ライブラー情報量(KLダイバージェンス)」が常に0以上になること(ギブスの不等式)の証明です。
$$D_{\mathrm{KL}}(P \parallel Q) = \sum_{x} P(x) \log \frac{P(x)}{Q(x)} = - \sum_{x} P(x) \log \frac{Q(x)}{P(x)}$$
ここで $f(t) = -\log t$ は下に凸な関数です。期待値の定義に基づきイェンセンの不等式を適用すると、以下の変形が成り立ちます。
$$D_{\mathrm{KL}}(P \parallel Q) = E_{P}\left[ -\log \frac{Q(X)}{P(X)} \right] \ge -\log E_{P}\left[ \frac{Q(X)}{P(X)} \right] = -\log \sum_{x} P(x) \frac{Q(x)}{P(x)} = -\log(1) = 0$$
この結果により、$D_{\mathrm{KL}}(P \parallel Q) \ge 0$ が担保され、分布間の「距離のような指標」として安心して利用できる理論的裏付けが得られます。
さらに現代の深層生成モデルを代表する変分オートエンコーダ(VAE)や、不完全データからパラメータを推定するEMアルゴリズムでは、この性質がフル活用されています。
観測データ $x$ の対数尤度 $\log p(x)$ を直接最大化したいものの、潜在変数 $z$ の積分が困難で計算できない(Intractable)状況を考えます。ここで近似事後分布 $q(z|x)$ を導入し、対数関数(上に凸)に対してイェンセンの不等式を適用します。
$$\log p(x) = \log \int p(x, z) dz = \log \int q(z|x) \frac{p(x, z)}{q(z|x)} dz = \log E_{q}\left[ \frac{p(x, z)}{q(z|x)} \right] \ge E_{q}\left[ \log \frac{p(x, z)}{q(z|x)} \right]$$
この不等式の右辺こそが、機械学習で頻出する「証拠下界(ELBO: Evidence Lower Bound)」です。計算不可能な対数尤度を直接追う代わりに、イェンセンの不等式によって作り出した下界(ELBO)をニューラルネットワークで最大化することで、複雑な画像や音声の生成モデルが安定して学習できるようになっています。


